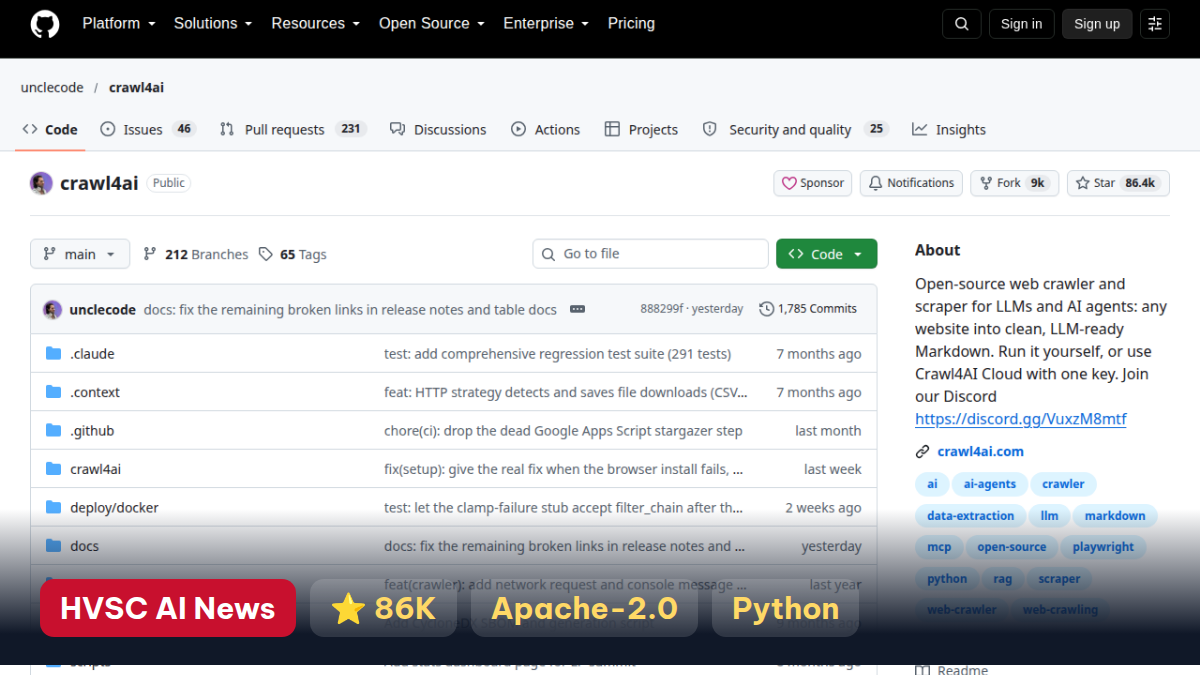
Crawl4AI là trình thu thập web mã nguồn mở, làm đầu ra sẵn cho mô hình ngôn ngữ và agent AI.
Nó làm được gì
- Xuất Markdown sạch gồm tiêu đề, danh sách, bảng, đoạn mã.
- Có bộ lọc bỏ menu, chân trang và phần thừa.
- Trích dữ liệu có cấu trúc bằng CSS, XPath hoặc qua mô hình ngôn ngữ.
- Điều khiển trình duyệt: giữ phiên, cookie, proxy, nhiều loại trình duyệt.
- Dùng bằng thư viện Python, dòng lệnh hoặc Docker.
- Có thêm bản đám mây của hãng, tách riêng với bản mã nguồn mở.
Hợp với ai
Người cần gom tài liệu công khai để phân tích, hoặc dựng kho tri thức cho chatbot.
Cần cân nhắc
- Thu thập web phải tôn trọng điều khoản website và robots.txt.
- Không thu dữ liệu cá nhân của người khác.
- README có chế độ ẩn danh (stealth) và proxy. Dùng đúng mục đích hợp pháp.
- Trích bằng mô hình ngôn ngữ cần khoá API và có thể phát sinh phí.
Thử an toàn
Cài trong môi trường ảo hoặc máy ảo riêng, chạy trong máy ảo, chỉ thu thập trang của chính bạn hoặc trang cho phép, đặt giới hạn số trang và tốc độ. Chúng tôi chưa tự chạy thử mã của dự án này.
Số liệu GitHub
- Repo: Mở trên GitHub
- Sao: 86,394
- Giấy phép: Apache-2.0
- Ngôn ngữ: Python
- Repo cập nhật gần nhất: 2026-10-26 (số liệu lấy từ GitHub API)
- Ảnh chụp từ trang GitHub của dự án.
Cần tư vấn website, phần mềm hoặc bảo mật?
Mô tả bài toán, kỹ thuật HVSC trao đổi phạm vi và phương án phù hợp với doanh nghiệp.
Ban biên tập HVSC · Tổng hợpTổng hợp và biên tập bởi Ban biên tập HVSC · Cập nhật 27/10/26
Bài viết này có giúp ích cho bạn?Chạm vào số sao. Góp ý của bạn giúp Ban biên tập viết bài sát nhu cầu hơn.
 ▶
 ▶
 ▶
 ▶
 ▶
 ▶