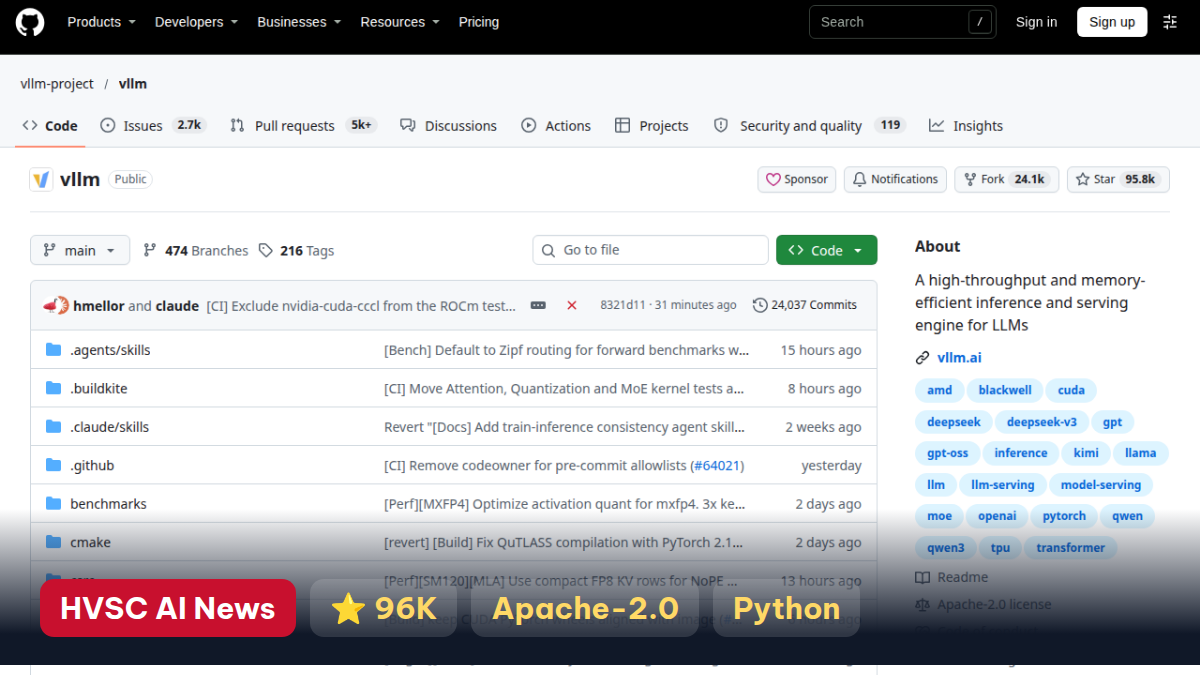
vLLM là thư viện chạy và phục vụ mô hình ngôn ngữ lớn, nhắm tới tốc độ cao và dùng bộ nhớ hiệu quả.
Nó làm được gì
- Quản lý bộ nhớ khoá-giá trị của phần chú ý bằng PagedAttention, gộp yêu cầu liên tục để tăng thông lượng.
- Hỗ trợ nhiều kiểu lượng tử hoá như FP8, INT8, INT4, GPTQ, AWQ, GGUF.
- Chạy phân tán: song song tensor, pipeline, dữ liệu, chuyên gia.
- Có máy chủ API tương thích OpenAI, thêm Anthropic Messages API và gRPC.
- Hỗ trợ đầu ra có cấu trúc, gọi công cụ, nhiều LoRA cùng lúc.
- Chạy trên GPU NVIDIA, AMD, Intel và CPU x86, ARM, PowerPC; thêm plugin cho phần cứng khác.
- Dùng thẳng được nhiều mô hình trên Hugging Face (README nói hơn 200 kiến trúc).
Hợp với ai
Nhóm kỹ thuật cần tự chạy mô hình ngôn ngữ trên máy chủ riêng và phục vụ nhiều người dùng cùng lúc.
Cần cân nhắc
- Phục vụ mô hình lớn thường cần GPU mạnh; xem tài liệu để biết phần cứng được hỗ trợ.
- Mô hình tải thêm từ Hugging Face có giấy phép riêng, cần đọc trước khi dùng thương mại.
- Máy chủ API cần được đặt sau xác thực nếu mở ra ngoài mạng nội bộ.
Thử an toàn
Cài trong môi trường ảo hoặc máy ảo riêng, dùng dữ liệu mẫu không nhạy cảm, chỉ mở trên localhost và đọc kỹ giấy phép. Chúng tôi chưa tự chạy thử mã của dự án này.
Số liệu GitHub
- Repo: Mở trên GitHub
- Sao: 95,781
- Giấy phép: Apache-2.0
- Ngôn ngữ: Python
- Repo cập nhật gần nhất: 2026-10-28 (số liệu lấy từ GitHub API)
- Ảnh chụp từ trang GitHub của dự án.
Cần tư vấn website, phần mềm hoặc bảo mật?
Mô tả bài toán, kỹ thuật HVSC trao đổi phạm vi và phương án phù hợp với doanh nghiệp.
Ban biên tập HVSC · Tổng hợpTổng hợp và biên tập bởi Ban biên tập HVSC · Cập nhật 29/10/26
Bài viết này có giúp ích cho bạn?Chạm vào số sao. Góp ý của bạn giúp Ban biên tập viết bài sát nhu cầu hơn.
 ▶
 ▶
 ▶
 ▶
 ▶
 ▶